近日,云翼数据成功交付四川大学华西医院专病库建设项目,围绕认知障碍、癫痫、偏头痛、睡眠障碍四大神经系统疾病方向,构建覆盖「数据采集 — 治理融合 — 科研应用」全链路的专病数据库体系,为高水平临床研究与精准诊疗提供坚实的数据底座。
神经系统疾病是临床研究中最依赖多模态数据的领域之一:一次完整的诊疗过程,可能同时产生量表评估、检验检查、影像、脑电生理信号等异构数据。长期以来,这些数据分散在不同系统、不同科室、不同设备之中,格式各异、口径不一,科研人员往往要耗费大量精力在数据收集与整理上。专病库的价值,正是把这些分散的临床数据,转化为标准化、可检索、可分析的科研资产。
全维度采集:把临床数据的「碎片」拼成「全景」
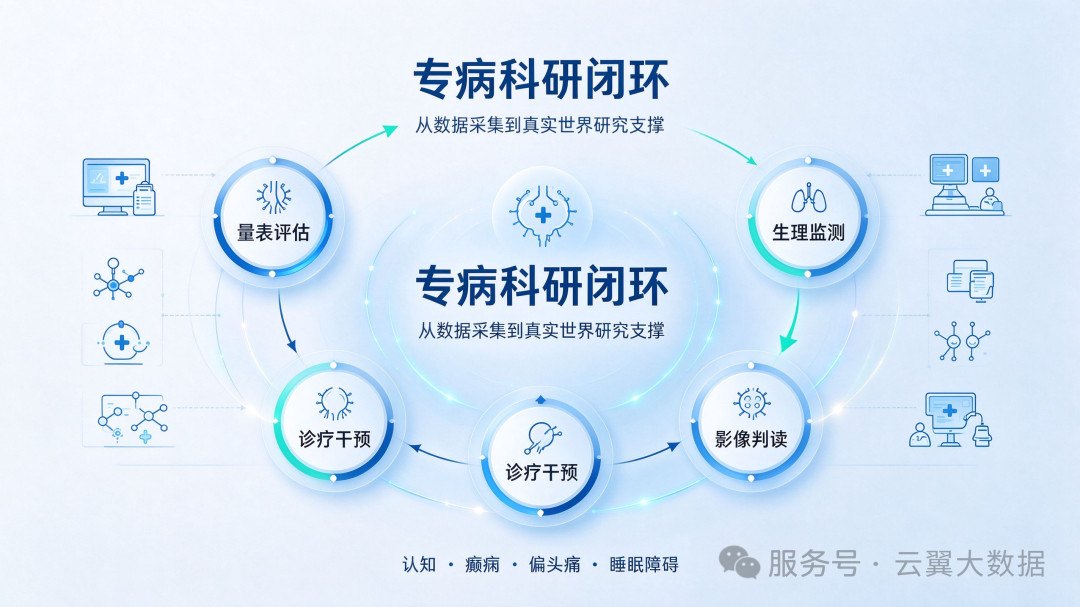
本次建设的四大专病库,核心能力是对临床研究患者全维度数据的系统性采集与汇聚。云翼数据深度对接医院相关临床信息系统,实现患者基本信息、临床数据、诊疗数据、干预数据、影像数据的自动化汇集,让每一次门诊、每一次评估、每一次干预都在专病库中留下完整、连续的数据轨迹。
针对神经系统疾病诊疗高度依赖量表评估的特点,专病库内置了各类国际标准试验量表的数字化采集能力,将纸质量表与人工录入转变为结构化、标准化的自动采集,从源头保证科研数据的规范性与一致性——这既减轻了临床一线的录入负担,也让多中心、长周期的队列研究有了统一的数据语言。
多模态融合:物联网设备与AI技术的深度落地
神经系统疾病研究的特殊性在于,关键证据往往来自专科设备。本项目按各专病特点,分别对接了脑电、胃电、眼动等多类专科物联网系统,将原本封存在设备厂商软件中的生理信号数据,实时接入专病库的统一数据体系,实现「设备数据 — 临床数据 — 诊疗数据」的同库关联。
在数据治理与智能化层面,云翼数据综合运用了图像识别、OCR、大模型等 AI 技术与大数据技术:图像识别与 OCR 技术让历史病历、纸质报告、影像资料实现自动结构化;大模型技术支撑非结构化病历文本的智能解析与信息抽取;大数据平台则为海量、高频、多模态数据的存储、治理与计算提供底座。多技术栈的协同,让专病库不仅是「数据的仓库」,更是「科研的生产线」。
懂医疗,才能建好医疗数据
医疗数据建设最大的门槛,从来不是技术,而是对医疗场景的理解。专病库建设的每一个决策——量表如何数字化、多模态数据如何对齐时间轴、专科设备数据以什么粒度入库、科研检索按什么逻辑组织——都需要建设者既懂数据工程,又懂临床科研的真实工作方式。
云翼数据长期深耕大数据与数据治理领域,在政务、制造、医疗等多个行业积累了从数据汇聚、治理到智能应用的完整落地经验。在本项目中,团队将成熟的数据治理方法论与神经系统疾病临床研究的特点深度结合:以科研需求倒推数据标准,以数据标准规范采集流程,以采集流程反哺临床工作——让数据建设真正嵌入医疗业务,而不是叠加在业务之上的额外负担。
从专病库到AI驱动的诊疗决策引擎
专病库的建设,只是第一步。它奠定的数据基石,指向一个更远的目标:深度融合人工智能技术,构建覆盖认知障碍、癫痫、偏头痛的 AI 诊疗一体化平台——从「数据的采集者」走向「智能的赋能者」。
这一平台将基于持续汇聚的海量专病数据研发 AI 模型,实现四类核心能力:智能辅助诊断,让医生在面对复杂病例时多一个不知疲倦的「第二视角」;疾病风险预测预警,把干预窗口从事后提前到事前;影像病灶精准识别,让人眼难以捕捉的细微异常无所遁形;个性化治疗方案推荐,让治疗决策建立在全维度数据证据之上。
其深层意义,在于推动诊疗模式从「被动治疗」向「主动精准干预」的根本性变革:数据不再只是科研的副产品,而是临床决策的生产资料;AI 不再是实验室里的演示,而是走进诊室、走进病房的日常能力。数据优势,由此真正转化为临床价值,科研能力与临床能力在同一条数据链路上同步提升。
让数据成为临床科研的新基建
从认知障碍的早期筛查研究,到癫痫的发作机制探索;从偏头痛的精准分型,到睡眠障碍的客观评估——高质量专病库是这一切研究工作的起点。云翼数据将持续以专业、严谨、可验证的工程能力,支撑华西医院神经系统疾病临床研究与智能诊疗的深入开展,也将把这一实践中沉淀的方法与能力,带给更多医疗机构。
好的专病库,不是建出来的系统,而是长出来的科研能力;好的诊疗智能,不是买回来的模型,而是从数据里长出来的临床价值。